Janela de contexto: por que a IA pode piorar em conversas longas
Você começa uma conversa com a IA e as primeiras respostas são boas. Trinta mensagens depois, ela ignora uma instrução importante, recupera uma versão que já tinha sido descartada ou simplesmente começa a responder pior.
A explicação comum é que a IA "esqueceu". Às vezes, porém, o problema é outro: há informação demais competindo pelo que realmente importa naquele momento.
Conversas longas podem piorar as respostas mesmo antes de atingir o limite máximo da ferramenta. Entender a janela de contexto ajuda a perceber por quê — e também explica por que começar uma conversa nova às vezes funciona melhor do que escrever um prompt ainda maior.
O que é a janela de contexto da IA
A documentação da Anthropic define a janela de contexto como o conjunto de texto que o modelo pode consultar enquanto gera uma resposta. Ela funciona como uma espécie de memória de trabalho.
Esse contexto é medido em tokens, pequenas unidades em que textos e outros conteúdos são processados pelo modelo.
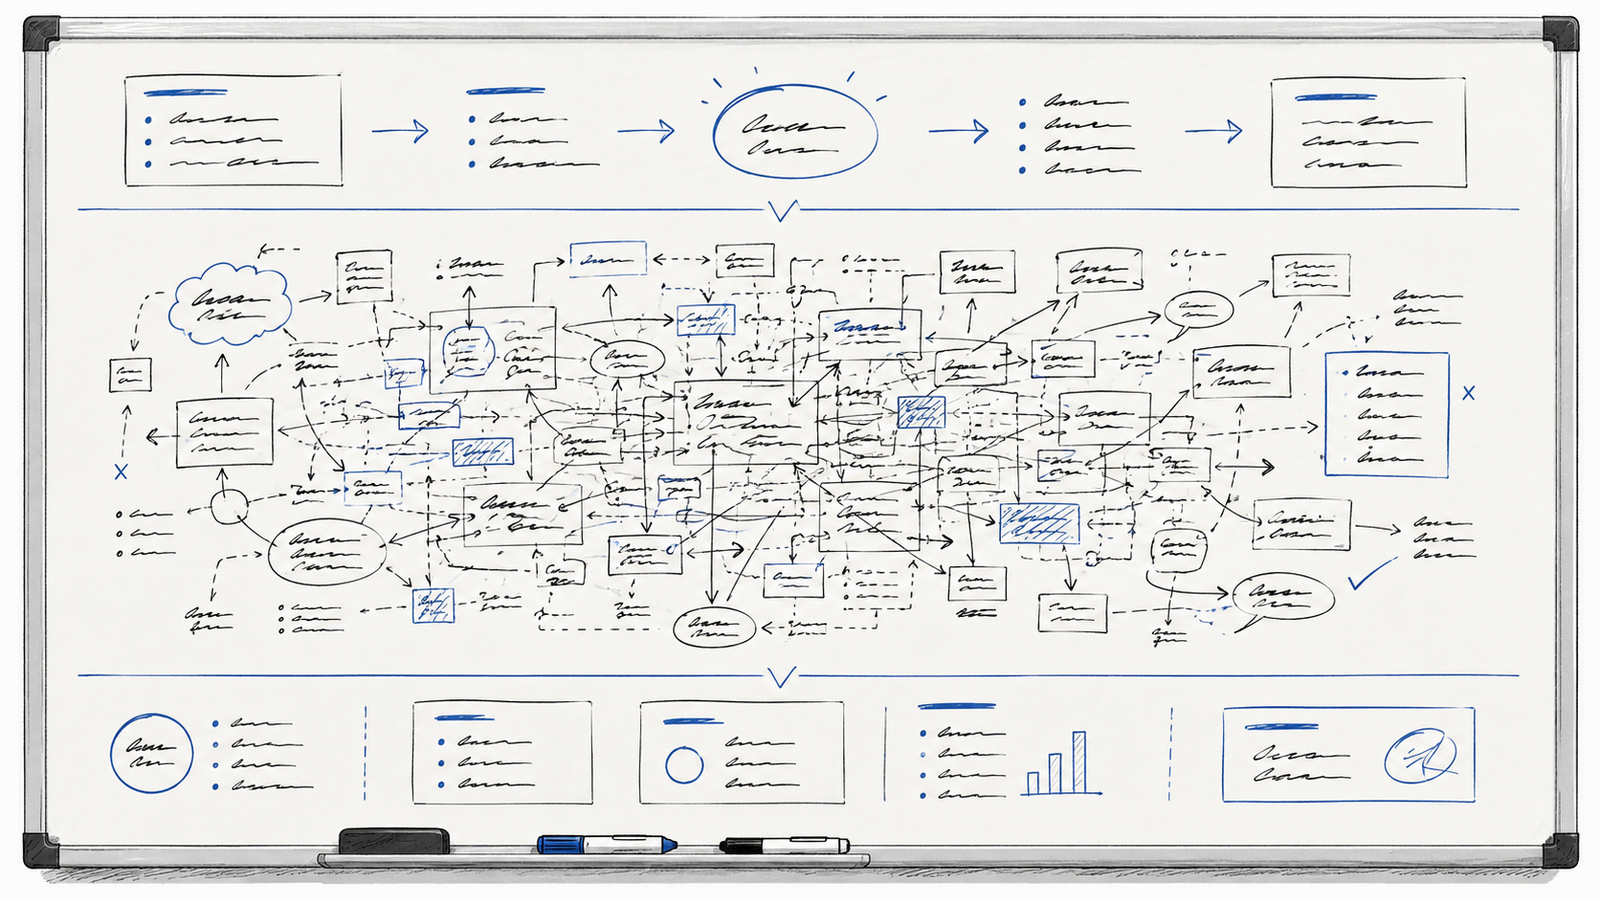
Uma imagem ajuda a entender.
Pense em um quadro branco. Para responder à sua pergunta, o modelo precisa trabalhar com o que foi colocado naquele quadro: instruções, mensagens anteriores, documentos, resultados de ferramentas e outras informações que o sistema decidiu fornecer naquele momento.
Quanto maior a janela, maior pode ser esse quadro. Mas há uma diferença importante entre caber no quadro e conseguir usar tudo que está nele com a mesma qualidade.
E existe mais um detalhe: não é correto imaginar que todos os aplicativos de IA simplesmente pegam a conversa inteira e reenviam exatamente da mesma maneira a cada resposta.
Esse é um comportamento comum em APIs, mas interfaces de chat podem gerenciar conversas longas usando estratégias como truncamento, janela móvel, recuperação de informações ou compactação de partes anteriores da conversa. A própria documentação da Anthropic faz essa distinção.
Por isso, é útil separar duas coisas: o modelo e o produto que você está usando. O produto pode decidir quais informações chegam ao modelo para aquela resposta.
Por que a resposta pode piorar mesmo quando ainda cabe tudo
Aqui está a parte mais interessante: atingir o limite máximo da janela não é o único problema.
A documentação da Anthropic observa que, conforme o número de tokens aumenta, precisão e recuperação podem se degradar. A empresa usa o termo context rot para descrever essa perda gradual de qualidade no uso de contextos maiores.
Em outras palavras: mais contexto não significa automaticamente uma resposta melhor.
O material da empresa sobre engenharia de contexto leva essa ideia um passo adiante: o objetivo não deveria ser colocar o máximo possível de informação diante do modelo, mas selecionar o conjunto de informações que realmente aumenta a chance de ele produzir o resultado desejado.
Há também evidência experimental para outro problema.
O artigo Lost in the Middle: How Language Models Use Long Contexts, de Nelson F. Liu e colegas, publicado em 2024 na Transactions of the Association for Computational Linguistics, avaliou modelos em tarefas que exigiam localizar informações dentro de contextos longos.
Nos experimentos, o desempenho frequentemente foi melhor quando a informação relevante estava próxima do começo ou do fim do contexto e pior quando ela aparecia no meio.
Isso não significa que o meio de toda conversa seja uma espécie de "zona proibida", nem que todos os modelos apresentem exatamente o mesmo comportamento. O estudo mostra algo mais útil: a posição e a quantidade de informação podem influenciar o quanto um modelo consegue aproveitar um contexto longo.
Um exemplo prático
Imagine uma conversa para revisar um plano de aula.
Você começa definindo quatro regras: público de primeiro período, linguagem simples, sem jargões e nenhuma atividade que dependa de laboratório.
A primeira versão vem certa.
Depois você pede alterações. A IA produz outra versão. Você corrige novamente. Diz que prefere a versão 2. Anexa a ementa. Experimenta outras alternativas. Descarta uma delas. Acrescenta novas orientações.
Vinte mensagens depois, aparece uma atividade que depende de laboratório.
É tentador dizer que a IA simplesmente "esqueceu". Mas há outra possibilidade.
Dependendo de como aquela ferramenta monta o contexto, o modelo pode estar recebendo a restrição original junto com várias versões do plano, novas instruções, correções, trechos da ementa e respostas anteriores.
A informação certa ainda pode estar presente. O problema é que agora ela precisa competir com muito mais material.
As versões descartadas também podem continuar no histórico disponível ao modelo. E, embora você saiba perfeitamente qual delas foi aprovada, essa distinção precisa estar clara no contexto atual para o modelo também.
O problema, portanto, não é apenas quantidade.
É quantidade, relevância, posição, contradição e clareza sobre qual informação continua válida.
O que fazer quando uma conversa começa a se perder
A solução não é decorar um "prompt mágico". Na maior parte dos casos, vale organizar melhor o contexto.
- Comece uma nova conversa quando o histórico ficar confuso. Se houve muitas tentativas, correções e mudanças de direção, faça um resumo do estado atual e continue a partir dele. Você elimina boa parte das decisões antigas que já não ajudam.
- Consolide em vez de corrigir indefinidamente. Depois de várias alterações, escreva algo como: "Considere a partir de agora apenas estas decisões". Em seguida, liste o que foi aprovado, o que foi descartado e quais restrições continuam valendo.
- Repita o que é realmente crítico. Se existe uma condição que não pode ser violada, não dependa exclusivamente de uma mensagem enviada dezenas de interações atrás. Coloque essa restrição novamente na solicitação atual.
- Separe assuntos quando eles deixarem de depender do mesmo contexto. Uma conversa pode começar discutindo um plano de aula e terminar falando de divulgação, orçamento e design. Nem tudo precisa ocupar o mesmo espaço de trabalho.
- Quando souber qual trecho importa, indique-o. Se você precisa analisar duas páginas de um documento de 80 páginas, diga quais são essas páginas ou envie apenas o trecho relevante quando isso for possível. Algumas ferramentas recuperam documentos de maneira inteligente, então o arquivo inteiro nem sempre é colocado integralmente no contexto. Mesmo assim, indicar o trecho relevante reduz ambiguidade.
Janela de contexto maior resolve?
Resolve um problema: permite colocar mais conteúdo à disposição do modelo.
Mas isso não resolve automaticamente o problema de usar bem esse conteúdo.
É justamente por isso que o número anunciado pelos fabricantes precisa ser interpretado com cuidado.
Uma janela de contexto maior pode permitir documentos maiores, conversas mais extensas e tarefas que antes simplesmente não caberiam. Isso é uma melhoria real.
Mas a própria documentação que descreve janelas enormes também alerta que mais contexto não é automaticamente melhor.
Essa é provavelmente a ideia mais importante deste texto:
Caber não é a mesma coisa que ser usado bem.
Uma conversa pode estar muito abaixo do limite máximo de tokens e, ainda assim, conter informação redundante, versões contraditórias e detalhes que dificultam a recuperação do que realmente importa.
Contexto não é a mesma coisa que memória
Essa distinção evita bastante confusão.
A janela de contexto representa as informações disponíveis ao modelo para produzir uma determinada resposta.
Já a memória é um recurso que alguns produtos implementam separadamente para preservar determinadas informações entre conversas.
O ChatGPT, por exemplo, possui mecanismos de memória e referência ao histórico que podem trazer informações de outras conversas quando esse recurso está habilitado.
Isso não significa que toda conversa anterior esteja permanentemente dentro da janela de contexto. Significa que o produto pode selecionar informações armazenadas anteriormente e adicioná-las ao contexto quando forem consideradas úteis.
Por isso, frases como "a IA não tem memória" ou "a IA lembra de tudo" simplificam demais uma arquitetura que hoje pode ter várias camadas diferentes.
Perguntas frequentes
Janela de contexto é a memória da IA?
Não exatamente. A janela de contexto funciona como uma memória de trabalho usada na geração da resposta atual. Produtos de IA também podem possuir sistemas separados de armazenamento, histórico, recuperação de informações e memória entre conversas.
A IA aprende com o que eu digo durante a conversa?
O que você escreve pode influenciar as respostas seguintes porque passa a fazer parte do contexto disponível naquela interação. Isso é diferente de o modelo ser treinado novamente a cada mensagem.
Também é importante separar esse mecanismo das políticas de uso de dados para melhoria dos modelos, que dependem do serviço e das configurações da conta.
Apagar ou editar uma mensagem antiga melhora a resposta?
Depende de como a ferramenta implementa a edição. Se a alteração realmente fizer com que aquele conteúdo deixe de integrar o contexto usado nas próximas respostas, reduzir informação irrelevante ou contraditória pode ajudar. A interface visual, sozinha, não permite concluir como o contexto está sendo montado internamente.
Como saber que estou perto do limite da janela?
Algumas ferramentas mostram uso de tokens ou oferecem indicadores técnicos. Muitas não mostram.
Também não existe um sintoma simples que prove que você está perto do limite. Instruções ignoradas, respostas genéricas ou retorno de erros antigos podem acontecer por diferentes razões e até aparecer muito antes do limite máximo.
Se a conversa acumulou muitas versões e ficou difícil até para você resumir o que ainda vale, provavelmente já existe um bom motivo para consolidar o contexto ou começar outra conversa.
Vale dividir um documento grande em partes?
Sim, quando a divisão ajuda a colocar diante do modelo apenas o que é relevante para aquela tarefa.
Dividir um documento em dez partes e enviar as dez para a mesma conversa não necessariamente reduz o problema. O ganho aparece quando você consegue selecionar melhor o que precisa ser analisado naquele momento.
O que fica
Quando uma conversa com IA começa a piorar, aumentar o prompt nem sempre é a resposta.
Às vezes, a pergunta mais útil é outra:
O que essa IA realmente precisa ter diante dela para responder bem agora?
Essa mudança parece pequena, mas altera a forma de usar a ferramenta. Em vez de tratar contexto como um depósito onde tudo deve ser guardado, você começa a tratá-lo como espaço de trabalho.
Da próxima vez que uma resposta piorar depois de dezenas de mensagens, vale verificar não apenas o que você acabou de pedir, mas também quanto histórico, quantas versões e quantas instruções diferentes estão competindo com esse pedido.
Como este artigo foi produzido
Conteúdo produzido com apoio de inteligência artificial, a partir de documentação oficial e artigo científico. As informações foram verificadas nas fontes consultadas e o texto passou por revisão humana antes da publicação
Fontes consultadas
- Anthropic — Context windows (consultada em 15/08/2026)
- Liu, N. F. et al. — Lost in the Middle: How Language Models Use Long Contexts (consultada em 15/08/2026)
- Anthropic — Effective context engineering for AI agents (consultada em 15/08/2026)
- OpenAI — How does “Reference saved memories” work? (consultada em 15/08/2026)