A IA aprende com suas conversas? Entenda o que acontece com seus dados
Você conta alguma coisa para uma inteligência artificial.
Cinco mensagens depois, ela usa aquela informação na resposta.
No dia seguinte, talvez até consiga retomá-la em uma nova conversa.
Então a IA aprendeu com você?
Não necessariamente.
Essa confusão acontece porque usamos a palavra “aprender” para processos tecnicamente diferentes.
Uma informação pode estar disponível apenas durante a conversa. Pode permanecer no histórico. Pode ser guardada por algum mecanismo de memória. Pode continuar armazenada nos sistemas da empresa. E, dependendo do produto, da conta e das configurações, pode ser elegível para processos posteriores de melhoria ou treinamento.
Essas coisas podem se relacionar.
Mas uma não implica automaticamente a outra.
Usar o que você disse não significa que o modelo aprendeu
Imagine que você escreva:
“Estou preparando uma apresentação para professores. Evite termos muito técnicos.”
Dez mensagens depois, a IA continua explicando tudo de forma simples.
Isso não significa que os parâmetros do modelo foram alterados por causa da sua mensagem.
Durante uma conversa, o sistema disponibiliza informações para que o modelo produza a resposta seguinte.
Esse conjunto faz parte do contexto.
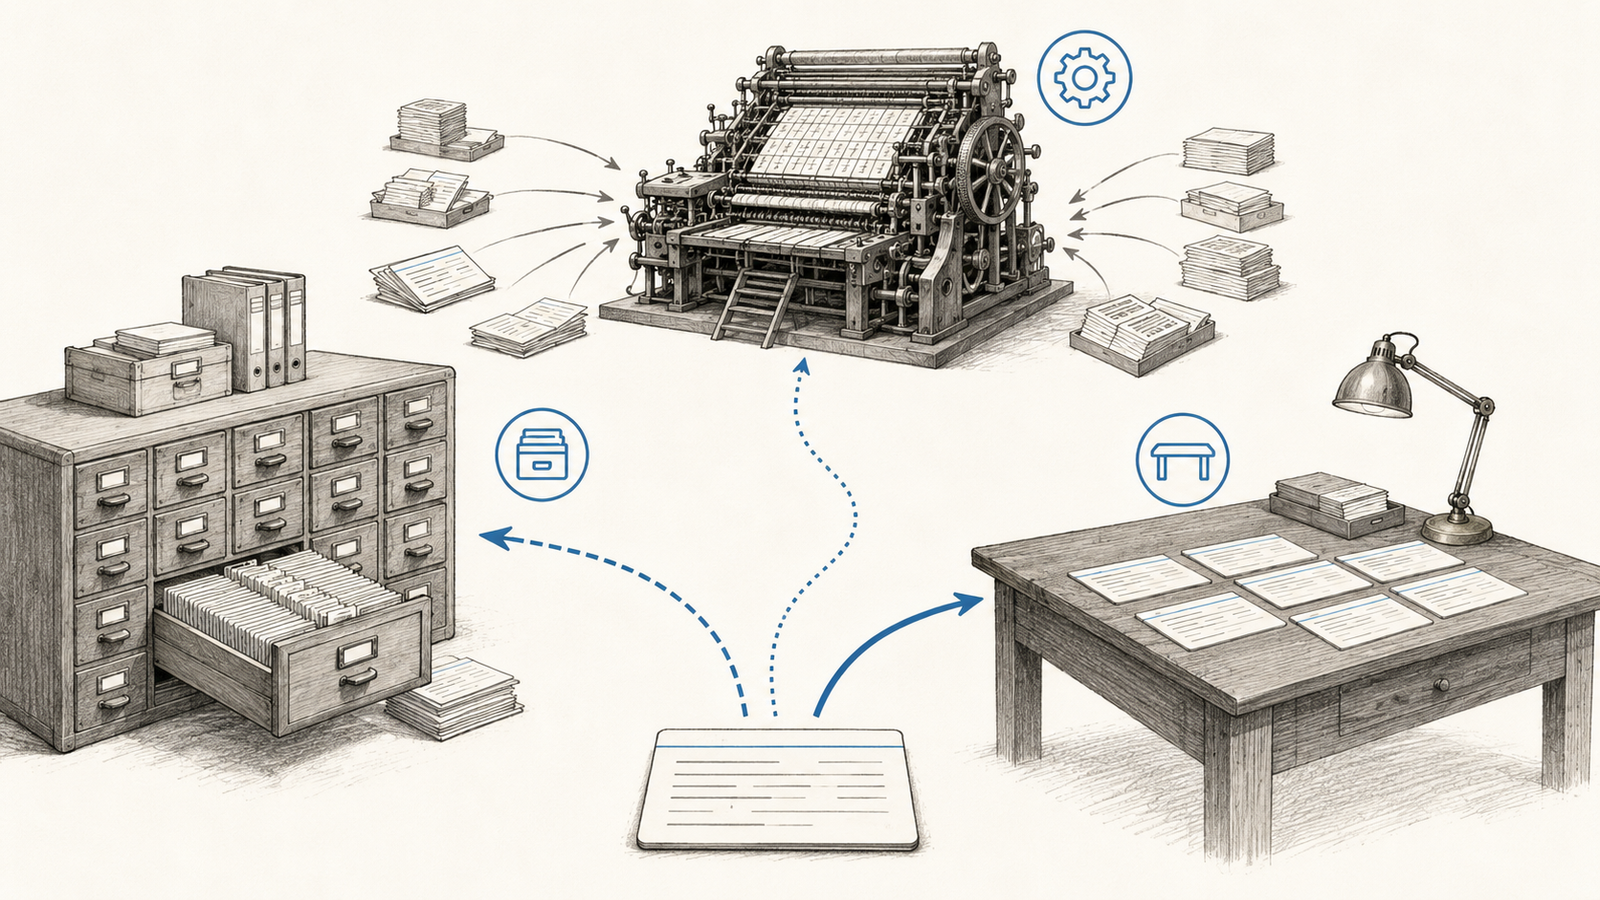
No artigo sobre janela de contexto, usamos a metáfora de uma mesa de trabalho: o modelo responde com base no material que o sistema colocou sobre essa mesa naquele momento.
Se a instrução “evite termos muito técnicos” continua disponível ali, ela pode influenciar as próximas respostas.
Isso é uso de contexto. Não é, por si só, treinamento.
E se ela lembrar disso amanhã?
A situação muda, mas a conclusão continua sendo a mesma.
Alguns produtos possuem mecanismos capazes de reutilizar informações entre conversas.
No artigo sobre memória, histórico e contexto, mostramos que uma preferência pode ser armazenada fora dos parâmetros do modelo e depois recuperada quando parecer relevante.
Por exemplo:
“Prefiro explicações sem jargão.”
O sistema pode manter essa informação associada à sua conta e disponibilizá-la novamente em outra conversa.
Isso permite personalização sem exigir que o modelo inteiro seja retreinado por causa de uma preferência individual.
Por isso:
lembrar de uma informação não significa necessariamente ter sido treinado com ela.
Contexto, memória, armazenamento e treinamento são coisas diferentes
Uma forma simples de separar os conceitos é esta:
- Contexto: informação disponibilizada para produzir a resposta atual.
- Histórico: registro de conversas mantido pelo serviço.
- Memória: informação reutilizada para personalizar interações futuras.
- Retenção: período pelo qual determinados dados permanecem armazenados.
- Treinamento: processo que modifica parâmetros de um modelo a partir de dados.
- Avaliação e melhoria: processos usados para analisar respostas, segurança e desenvolvimento dos sistemas.
Essa distinção evita várias conclusões erradas.
“A conversa está salva” não significa “entrou no treinamento”.
“A IA lembrou de mim” não significa “meus dados foram incorporados ao modelo”.
E “desativei o treinamento” não significa necessariamente “nenhuma informação será armazenada”.
O que significa treinar um modelo?
Grandes modelos de linguagem possuem enormes conjuntos de valores numéricos chamados parâmetros ou pesos.
Durante o treinamento, esses valores são ajustados a partir de muitos exemplos.
Esse processo permite que o modelo aprenda regularidades da linguagem, relações entre conceitos e padrões presentes nos dados utilizados.
Não é a mesma coisa que adicionar uma nova linha a um cadastro.
Em um banco de dados convencional, poderíamos ter algo como:
Paulo → cachorro → Bento
E depois recuperar exatamente esse registro.
O treinamento de um modelo não funciona, em geral, como uma grande tabela pesquisável contendo cada frase que apareceu nos dados.
Ele altera os parâmetros do sistema a partir dos exemplos utilizados.
Por isso, quando você envia uma mensagem às 14h03, não é correto imaginar que aquela frase alterou instantaneamente o modelo disponível para todos os usuários às 14h04.
O funcionamento normal de uma conversa e o treinamento do modelo são processos distintos.
Então minhas conversas nunca alteram o modelo?
Também não é isso.
Dependendo do serviço, do tipo de conta e das configurações escolhidas, conversas podem ser elegíveis para processos posteriores de melhoria ou treinamento.
A palavra importante é posteriores.
Quando um fornecedor informa que determinadas conversas podem ser usadas para melhorar seus modelos, isso não significa que cada mensagem esteja modificando os parâmetros enquanto a conversa acontece.
Esses dados podem passar posteriormente por processos de seleção, preparação, avaliação, filtragem e desenvolvimento definidos pelo fornecedor.
Há ainda outra nuance:
uma conversa ser elegível para treinamento não prova que aquela conversa específica foi efetivamente utilizada em determinado conjunto de treinamento.
Uma política descreve o que o fornecedor pode fazer com determinada categoria de dados.
Ela não permite concluir que cada interação permitida foi individualmente utilizada para alterar um modelo.
Mas um modelo pode memorizar informações?
Sim.
E esse detalhe impede outra simplificação comum.
Dizer que um modelo não funciona como um banco de dados não significa que ele seja incapaz de memorizar trechos dos dados utilizados em treinamento.
Em 2020, pesquisadores liderados por Nicholas Carlini demonstraram que era possível extrair do GPT-2 sequências literais presentes em seus dados de treinamento.
Entre os exemplos recuperados havia conteúdo que incluía informações identificáveis.
Trabalhos posteriores mostraram que fatores como repetição de um conteúdo no conjunto de treinamento e tamanho do modelo podem aumentar a probabilidade de memorização.
Também foram desenvolvidos métodos de extração capazes de recuperar dados de diferentes modelos em condições específicas.
Isso exige uma distinção importante.
Uma informação pode:
- ter aparecido nos dados de treinamento;
- ter sido memorizada pelo modelo;
- ser reproduzível em determinadas condições;
- e ser efetivamente recuperada por alguém.
Essas quatro coisas não são equivalentes.
Portanto, também seria incorreto afirmar:
“Se minha conversa entrou no treinamento, qualquer pessoa poderá perguntar e receber exatamente o que eu escrevi.”
A pesquisa mostra que memorização e extração podem ocorrer.
Não mostra que todo conteúdo usado em treinamento fique disponível como se o modelo fosse um mecanismo de busca.
O que acontece com conversas do ChatGPT?
As regras dependem do produto e das configurações.
Na documentação consultada em 16 de agosto de 2026, a OpenAI informa que conteúdo enviado aos seus serviços destinados a indivíduos, como o ChatGPT, pode ser utilizado para melhorar seus modelos.
O usuário pode desativar essa utilização pelo controle “Aprimorar o modelo para todos”.
Com essa opção desativada, novas conversas ainda podem permanecer no histórico, mas não são usadas para treinamento dos modelos.
Isso mostra novamente que:
histórico e treinamento são controles diferentes.
Existe uma ressalva importante: a OpenAI informa que, se o usuário enviar voluntariamente feedback sobre uma resposta, a conversa associada ao feedback poderá ser usada para treinamento mesmo quando o uso geral das conversas para melhoria estiver desativado.
Nos produtos ChatGPT Business, Enterprise e API, a empresa informa que entradas e saídas não são utilizadas para treinamento por padrão.
E o Chat Temporário?
O ChatGPT também oferece conversas temporárias.
Segundo a OpenAI, elas:
- não aparecem no histórico;
- não criam memórias;
- não utilizam memórias;
- não são usadas para treinamento.
Isso ainda não significa que nenhum dado passe pelos sistemas da empresa.
A OpenAI informa que uma cópia pode ser mantida por até 30 dias por motivos relacionados à segurança.
Essa diferença é importante:
“não é usado para treinamento” e “nunca ficou armazenado em nenhum servidor” são afirmações diferentes.
O que acontece no Claude?
A Anthropic também diferencia produtos de consumo e comerciais.
Na documentação vigente na data desta publicação, conversas de usuários de produtos de consumo como Claude Free, Pro e Max podem ser utilizadas para melhorar modelos quando o usuário permite esse uso.
A empresa também documenta situações relacionadas a segurança, feedback e outras formas específicas de participação.
Para produtos comerciais, incluindo Claude for Work e API, a Anthropic informa que entradas e saídas não são utilizadas para treinar seus modelos generativos por padrão.
Isso não significa que todas as modalidades comerciais de qualquer fornecedor devam ser tratadas da mesma maneira.
A regra precisa ser verificada no produto e no contrato efetivamente utilizados.
O que acontece no Gemini?
No Gemini para contas pessoais, uma configuração importante é Manter Atividade.
Segundo a documentação do Google consultada em agosto de 2026, quando essa configuração está ativa, a atividade salva pode ser utilizada para fornecer, desenvolver e melhorar os serviços do Google, inclusive modelos de IA generativa.
O Google também informa que parte das conversas pode passar por revisão humana.
Quando Manter Atividade está desativado, novas conversas não são utilizadas para treinamento dos modelos de IA, salvo situações como o envio voluntário de feedback.
Mesmo assim, o Google informa que conversas podem ser mantidas por até 72 horas para permitir o funcionamento do serviço e proteger seus sistemas.
Em determinados ambientes Google Workspace, as regras são diferentes das contas pessoais. O Google afirma que prompts, conteúdo e respostas desses ambientes não são usados para treinar modelos de IA generativa fora da organização sem permissão.
Então alguém pode ler minhas conversas?
Também não existe uma resposta universal.
Os fornecedores documentam situações em que partes dos dados podem passar por revisão humana para avaliação, desenvolvimento ou segurança.
Isso não significa que uma pessoa esteja lendo manualmente todas as conversas.
Mas também significa que não é prudente imaginar todo chatbot de consumo como um canal privado no qual nenhuma informação poderia ser acessada durante os processos do fornecedor.
A política aplicável depende do serviço, da configuração e do tipo de conta.
Apagar o chat desfaz o treinamento?
Não devemos tratar essas duas ações como equivalentes.
Excluir uma conversa atua sobre os dados armazenados pelo produto e inicia os procedimentos de exclusão definidos pelo fornecedor.
Treinamento é um processo diferente, que altera parâmetros de modelos.
Se determinados dados já participaram anteriormente de algum processo de desenvolvimento, apagar posteriormente o registro da conversa não deve ser interpretado automaticamente como uma forma de reverter esse treinamento.
Há ainda períodos de retenção e exceções previstas nas políticas dos serviços.
Por isso, para informações realmente sensíveis, a estratégia mais segura não é depender da possibilidade de apagá-las depois.
É evitar enviá-las quando elas não são necessárias para a tarefa.
Desativar treinamento transforma a IA em um cofre?
Não.
Esse é um erro importante porque transforma um controle específico em uma garantia muito maior do que ele realmente oferece.
Desativar o uso de conversas para treinamento pode impedir determinada utilização dos dados.
Mas o serviço ainda precisa processar aquilo que você envia para executar a tarefa.
Também podem existir:
- retenção temporária;
- logs de segurança;
- mecanismos contra abuso;
- integrações com serviços externos;
- administradores da organização;
- políticas específicas de determinados recursos.
Portanto, desativar treinamento não torna adequado enviar qualquer informação.
Especialmente:
- senhas;
- tokens;
- chaves de API;
- dados bancários;
- documentos confidenciais;
- informações médicas identificáveis;
- dados pessoais de clientes ou alunos;
- segredos comerciais;
- documentos internos sem autorização para compartilhamento.
Se o sistema não precisa daquela informação para executar a tarefa, a melhor proteção é não fornecê-la.
No trabalho, os dados podem nem ser seus
Existe uma diferença entre decidir o que fazer com seus próprios dados e enviar informações pertencentes a outras pessoas.
Uma planilha pode conter informações de clientes.
Um relatório pode ter dados de funcionários.
Uma escola pode trabalhar com informações de alunos.
Uma clínica pode lidar com dados de pacientes.
Nesses casos, a pergunta não deveria ser apenas:
“Essa IA usa meus dados para treinamento?”
Também é necessário perguntar:
“Eu tenho autorização e uma finalidade adequada para enviar esses dados a esse serviço?”
No Brasil, a Lei Geral de Proteção de Dados estabelece princípios como finalidade, necessidade e segurança no tratamento de dados pessoais.
Isso não significa que o uso de inteligência artificial com dados pessoais seja automaticamente proibido.
Significa que desligar uma opção de treinamento não elimina as responsabilidades existentes sobre o tratamento dessas informações.
Conta empresarial faz diferença?
Pode fazer bastante diferença.
OpenAI, Anthropic e Google documentam condições específicas para alguns de seus produtos empresariais.
Por isso, em uma organização, a discussão não deveria terminar em:
“Podemos usar ChatGPT, Claude ou Gemini?”
A pergunta correta precisa ser mais específica:
“Qual produto, qual plano, qual contrato e com quais configurações?”
Uma conta pessoal e uma modalidade empresarial do mesmo fornecedor podem ter compromissos diferentes sobre treinamento, retenção, administração e proteção dos dados.
Como reduzir o que você envia
Existe uma estratégia simples que independe de qual fornecedor está sendo usado:
minimizar o dado.
Se a IA precisa revisar um e-mail, talvez não precise do nome completo do cliente.
Se precisa ajudar a analisar uma planilha, talvez identificadores possam ser substituídos.
Se precisa explicar um caso, talvez o exemplo possa ser anonimizado.
Antes de enviar alguma informação, faça três perguntas:
- A IA realmente precisa disso para executar a tarefa?
- O que este produto faz com os dados que envio?
- Eu poderia entregar essa mesma informação a outro fornecedor externo?
Se a resposta à primeira pergunta for não, você já encontrou a melhor solução.
Não envie.
Treinamento torna a IA uma fonte confiável?
Também não.
Mesmo modelos treinados com enormes quantidades de informação podem produzir respostas factualmente incorretas.
É justamente o problema discutido no artigo sobre alucinação em inteligência artificial.
O treinamento permite ao modelo aprender padrões a partir dos dados.
Isso não transforma seus parâmetros em um banco de fatos capaz de recuperar cada informação corretamente sempre que ela for solicitada.
Ter encontrado uma informação durante o treinamento e conseguir reproduzi-la corretamente depois são coisas diferentes.
Perguntas frequentes
Tudo o que escrevo para uma IA vira treinamento?
Não. Isso depende do serviço, do tipo de conta, das configurações e do recurso utilizado. Uma conversa também pode permanecer armazenada sem ser usada para treinamento.
Se a IA usa algo que eu disse cinco mensagens atrás, ela aprendeu comigo?
Não necessariamente. Essa informação pode simplesmente continuar disponível no contexto da conversa.
Se ela lembrar amanhã, significa que foi treinada com meus dados?
Não. O produto pode manter mecanismos de memória ou personalização separados do treinamento do modelo.
Desativar treinamento significa que nada fica armazenado?
Não. Armazenamento, histórico, memória, retenção e treinamento são mecanismos diferentes.
Chat temporário não fica em servidor nenhum?
Essa conclusão é incorreta. Os fornecedores podem manter essas conversas temporariamente para funcionamento, segurança ou prevenção de abuso, mesmo quando elas não aparecem no histórico nem são usadas para treinamento.
Apagar uma conversa desfaz o treinamento?
Não devemos assumir isso. A exclusão do registro da conversa e o treinamento de um modelo são processos distintos.
O modelo guarda cópias dos textos de treinamento?
Ele não funciona simplesmente como um banco de dados pesquisável contendo todos os textos originais. Mas pesquisas mostram que modelos podem memorizar e, em determinadas condições, reproduzir literalmente partes dos dados de treinamento.
Se algo entrou no treinamento, qualquer pessoa consegue recuperar?
Não. Memorização, possibilidade de extração e recuperação efetiva são fenômenos diferentes. Pesquisas demonstram que dados podem ser extraídos em determinadas condições, mas isso não transforma todo o conteúdo do treinamento em informação recuperável sob demanda.
Produtos empresariais nunca usam dados para treinamento?
Não vale transformar isso em regra universal. Alguns fornecedores assumem compromissos de não utilizar entradas e saídas de determinados produtos empresariais para treinamento por padrão. É necessário verificar o produto e o contrato específicos.
Se eu desativar treinamento, posso enviar qualquer informação confidencial?
Não. O serviço ainda precisa processar aquilo que você envia e outras formas de armazenamento, retenção e acesso podem existir. Dados desnecessários ou altamente sensíveis não deveriam ser enviados apenas porque uma opção de treinamento foi desativada.
O que fica
A frase “a IA aprende com tudo o que você fala” parece explicar o problema.
Na verdade, mistura várias coisas.
Durante uma conversa, sua informação pode estar no contexto.
Depois, ela pode permanecer no histórico.
Alguma informação pode ser reutilizada como memória.
O fornecedor pode manter determinados dados por um período de retenção.
E, dependendo do serviço e das configurações, a conversa pode ser elegível para processos posteriores de treinamento ou melhoria.
Uma camada não prova a existência da outra.
E talvez exista uma pergunta mais útil do que simplesmente:
“A IA vai aprender isso?”
Para que essa informação precisa entrar nesse sistema?
Se ela não é necessária para a tarefa, talvez a melhor política de privacidade seja a mais simples de todas:
não enviar.
Como este artigo foi produzido
Conteúdo produzido com apoio de inteligência artificial, a partir de documentação oficial dos fornecedores citados e literatura científica sobre treinamento e memorização em modelos de linguagem. As afirmações factuais foram verificadas nas fontes consultadas e o texto passou por revisão humana antes da publicação.
Fontes consultadas
- OpenAI — How your data is used to improve model performance (consultada em 16/08/2026)
- OpenAI — Data Controls FAQ (consultada em 16/08/2026)
- OpenAI — How ChatGPT and our foundation models are developed (consultada em 16/08/2026)
- OpenAI — Temporary Chat FAQ (consultada em 16/08/2026)
- Anthropic — Is my data used for model training? (consultada em 16/08/2026)
- Anthropic — How Do You Use Personal Data in Model Training? (consultada em 16/08/2026)
- Google — Gemini Apps Privacy Hub (consultada em 16/08/2026)
- Google — Generative AI in Google Workspace Privacy Hub (consultada em 16/08/2026)
- Carlini et al. — Extracting Training Data from Large Language Models (consultada em 16/08/2026)
- Carlini et al. — Quantifying Memorization Across Neural Language Models (consultada em 16/08/2026)
- Lee et al. — Deduplicating Training Data Makes Language Models Better (consultada em 16/08/2026)
- Nasr et al. — Scalable Extraction of Training Data from (Production) Language Models (consultada em 16/08/2026)
- Brasil — Lei nº 13.709/2018 — Lei Geral de Proteção de Dados Pessoais (consultada em 16/08/2026)